首页/新闻资讯/正文详情

自己动手,搭一个 AI 资讯聚合平台

发布时间:2026/9/27 4:33:16 来源:云帆数科 栏目:资讯中心
自己动手,搭一个 AI 资讯聚合平台
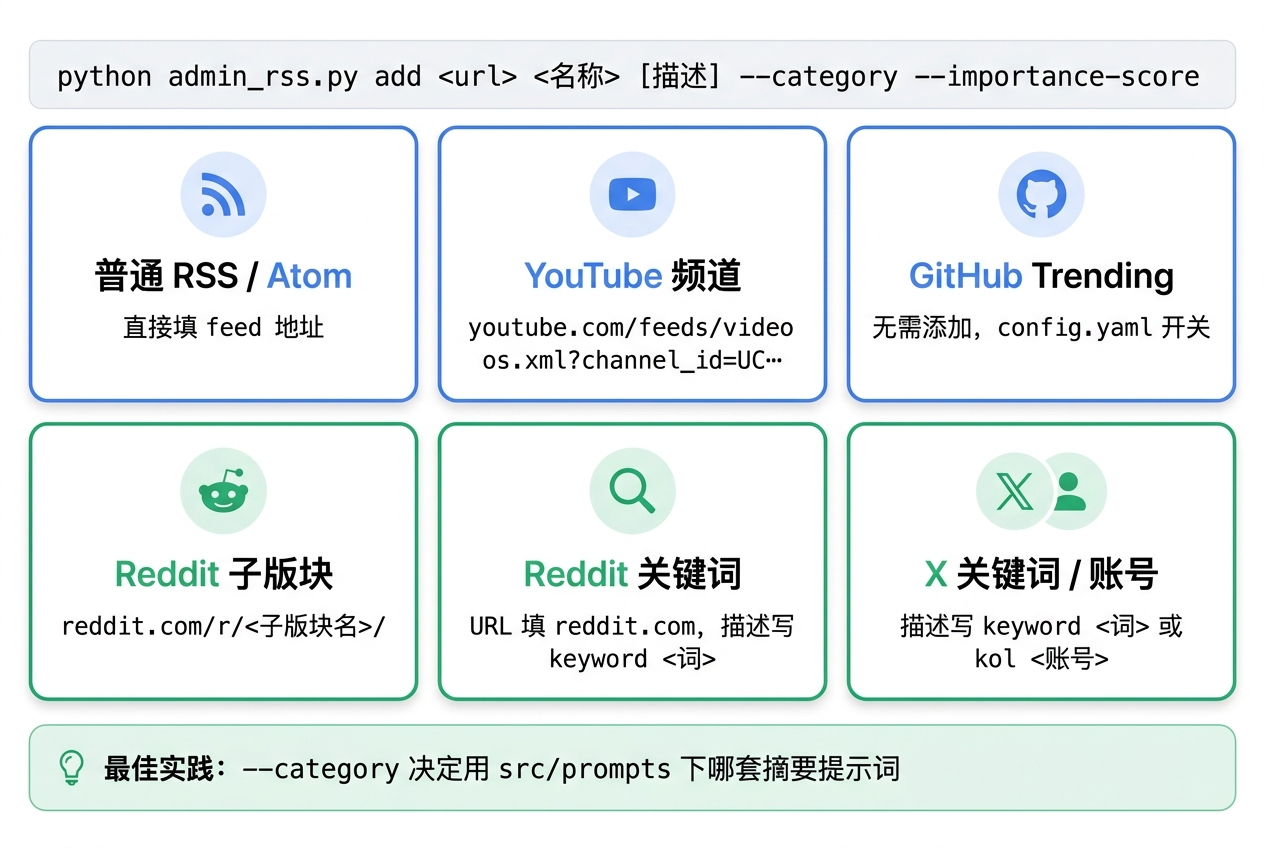
做 AI 相关工作的人大概都有过这种体验每天早上先刷一遍 X再看几个大厂博客然后去 Hacker News 和 Reddit 翻翻评论区晚上再补几期 YouTube 访谈。一圈下来一两个小时没了真正有用的信息可能就那么几条。问题不在信息少而在于信息太散、太杂、太重复。这篇文章从这个需求出发拆一拆一个能自动跑起来的 AI 资讯平台该怎么设计最后手把手部署一套。1、先把需求说清楚四个要解决的问题把“每天刷资讯”这件事拆开看其实是四个具体的问题。第一源太多、格式不一。官方博客有 RSSHacker News 有评论区Reddit 按子版块组织X 是一条条帖子YouTube 是视频。想统一收进来每类源都得有自己的采集方式。第二噪声太多。科技媒体的 RSS 里一半不是 AI 内容社媒上大量帖子没人互动。需要有人帮你先筛一遍。第三重复太多。一个模型发布官方博客发一遍TechCrunch 报道一遍X 上几十个人转发评论。你不想看同一件事十遍。第四读原文太费时间。一篇长博客、一期两小时的播客你需要的往往只是几百字的要点最好中英文都有。这四个问题正好对应一条流水线的四个环节采集、过滤、去重、摘要。2、技术方案一条流水线四个环节采集层按源的类型分开处理。RSS/Atom 最简单解析 feed 就行。Hacker News 除了帖子本身还要把评论区一起抓下来因为很多有价值的观点在评论里。YouTube 视频取字幕文本把“看视频”变成“读文字”。GitHub Trending 取仓库的 README 和元数据。讨论类内容还要设一道互动门槛点赞和评论数不够的帖子先不处理记下来过段时间再复查。刚发出来的帖子互动少直接判死刑容易漏掉后来火起来的。过滤和摘要层交给大模型。每篇文章送进去一次调用拿回四样东西相关性判断、中英双语摘要、标签、重要性评分。这里有个简单但好用的约定和 AI 无关的内容直接打 0 分0 分不入库过滤和打分合成一步。不同类型的内容摘要口径也不一样。新闻要讲清事实和影响讨论帖要提炼各方观点开源项目要说明它解决什么问题。所以提示词按类别分开写每类一套。去重层是整条流水线里最值得说的部分分两级第一级是 SimHash。对全文算一个指纹两个指纹的汉明距离不超过 3 就算重复。它便宜而且放在调用大模型之前转载、镜像这类几乎一字不差的内容在这一步就被拦掉省下的是真金白银的 token。第二级是语义去重。不同媒体报道同一件事措辞完全不同SimHash 认不出来。这时把摘要和标签用本地的 all-MiniLM-L6-v2 模型转成向量在数据库里用 pgvector 查余弦相似度超过 0.85 就算重复。24 小时内的新文章阈值放宽到 0.80因为同一个热点集中爆发时重复报道最多。存储层用带 pgvector 扩展的 PostgreSQL。文章、源列表、向量都在一个库里语义去重直接用一条 SQL 查询完成不用另外维护一个向量数据库。最后用一个调度器把这些串起来定时跑一轮。![这套方案我们自己已经跑了一段时间代码整理成了开源项目ai-news-briefMIT 协议。下面就用它从零部署一套数据库用 Supabase 的免费项目。3、准备工作你需要三样东西Python 3.10 以上。一个大模型 API key。任何 OpenAI 兼容的接口都行项目默认用 DeepSeek换别家只要改接口地址和 key。一个 Supabase 免费项目。它自带 PostgreSQLpgvector 开个开关就能用省去自己装数据库的麻烦。另外可选一个 GitHub Token。不填也能抓 GitHub Trending填了以后 GitHub API 的限额从每小时 60 次提到 5000 次。4、配置 Supabase开扩展、拿连接串在 Supabase 新建项目。建项目时要设一个数据库密码记下来后面要用。然后启用 pgvector两种方式任选一种。一种是点界面进 Dashboard 的 Database 页面左侧栏点 Extensions搜 vector打开开关。另一种是在 SQL Editor 里执行CREATEEXTENSIONIFNOTEXISTSvector;表不用手动建程序第一次运行时会自动创建。接下来拿连接串。点 Dashboard 顶部的 Connect 按钮这里要看你的网络环境。网络支持 IPv6 的话选 Direct connectionpostgresql://postgres:[YOUR-PASSWORD]db.[PROJECT-REF].supabase.co:5432/postgres网络只有 IPv4 的话国内家庭宽带和公司网络大多是这样直连会失败要选 Session poolerpostgresql://postgres.[PROJECT-REF]:[YOUR-PASSWORD][POOLER-HOST]:5432/postgres注意两点。一是主机名和用户名直接从 Connect 弹窗里复制别自己拼。pooler 的主机名带一个集群编号没法从地区推出来pooler 连接的用户名也和直连不一样是postgres.项目ID的形式。二是把[YOUR-PASSWORD]换成你的密码时如果密码里有、#、?或空格要做百分号编码否则连不上。5、拉代码、填配置gitclone https://github.com/frankzch/ai-news-brief.gitcdai-news-brief pipinstall-rrequirements.txt playwrightinstallchromium最后一行装的是 Chromium 内核有些网页的正文要靠浏览器渲染后才能取到。复制一份环境变量模板cp.env.example .env.env里必填两项DEEPSEEK_API_KEY大模型 key。用别家就改填INBRIEF_LLM_API_KEY和INBRIEF_LLM_BASE_URL。INBRIEF_SUPABASE_DB_URL刚才复制的连接串。GITHUB_TOKEN选填。其余参数都在config.yaml里常改的有这几个配置项默认值作用llm.model_namedeepseek-v4-flash摘要用的模型schedule.interval_hours2调度模式下每几小时跑一轮fetching.max_entries50单轮最多处理多少篇fetching.concurrency5并发处理数fetching.article_max_age_days1超过几天的旧文章跳过fetching.discussion.min_likes/min_replies100 / 50讨论帖的互动门槛fetching.github_trending.max_repos25GitHub Trending 取前多少个cleanup.article_retention_days7文章保留几天后自动清理6、加信息源跑起来源列表存在数据库的rss_sources表里用自带的admin_rss.py管理# 添加python admin_rss.pyaddhttps://openai.com/news/rss.xmlOpenAI Blog--categorynews# 查看python admin_rss.py list# 删除会先要求确认python admin_rss.py deleteidGitHub Trending 不用加源在config.yaml里默认开着。第一次跑建议只加几个官方博客这类普通 RSS 源先把整条链路走通python main.py--now--now表示立即跑一轮。看日志能看到每篇文章的去向被 SimHash 拦掉、被判定与 AI 无关、被语义去重还是成功入库。没问题以后去掉参数进入调度模式长期运行python main.py结果存在articles表里在 Supabase 的 Table Editor 里能直接看每条都有中英文标题、短摘要、长摘要、标签和重要性分数。7、扩展从 94 个源的目录开始加你自己的源程序本身不预置任何源加什么全由你决定。项目 README 里附了一份我们在用的源目录一共 94 个可以直接照着挑类别数量内容新闻与博客16 个 RSSOpenAI、Google DeepMind、Google Research、Apple ML、Microsoft AI、Nvidia、Hugging Face 等官方博客与 HF Daily Papers加上 TechCrunch、The Verge、MIT 科技评论、VentureBeat 等媒体讨论HN 16 个 Reddit 47 个 XHN 首页含评论区Reddit 11 个子版块加 5 个关键词X 35 位 AI 从业者Karpathy、Simon Willison 等加 12 个关键词视频13 个 YouTube 频道Lex Fridman、Dwarkesh Patel、Latent Space、Two Minute Papers 等按字幕生成摘要开源GitHub Trending每周热门仓库要加目录之外的源只需要知道每类源的写法。程序按 URL 自动识别类型![普通 RSS / Atom直接填 feed 地址。大部分博客、媒体都有。YouTube 频道填频道 feedhttps://www.youtube.com/feeds/videos.xml?channel_idUC...。Reddit 子版块https://www.reddit.com/r/子版块名/抓热帖。Reddit 关键词URL 填 reddit.com描述写keyword 关键词。XURL 填 x.com描述写keyword 关键词按关键词搜写kol 账号名跟踪某个人。社媒类的源在运行前还有一些额外设置项目 README 里有说明。加源时还有两个参数值得用好。--category决定这个源的文章用哪套提示词。src/prompts/下有news、discussion、kol、opensource四个 txt 文件类别名就对应文件名。觉得摘要风格不合口味直接改这几个文本文件不用碰代码。--importance-score是源的基础分默认 0。一篇文章的最终分数是大模型打的分和这个源分取平均讨论类再加上互动热度分一起平均。所以源分留 0 会把平均分拉低一半。你最信任的源比如各家官方博客给个高分它们的文章自然排在前面。8、嫌部署麻烦装一个 skill 就行如果你只是想每天看看 AI 圈发生了什么不想自己维护数据库和定时任务我们还做了另一个开源项目ai-news-skill。它是一个 Agent Skill背后接的就是用上面这套流水线跑出来的数据。支持 Claude Code、Codex、OpenClaw 和 Antigravity一条命令装好# Claude Codegitclone https://github.com/frankzch/ai-news-skill.git ~/.claude/skills/ai-news-skill其他 agent 换一下目录Codex 是~/.codex/skills/OpenClaw 是~/skills/Antigravity 是~/.agents/skills/。装好以后直接用自然语言问“过去 5 天头部 KOL 发布的 AI 视频排除 Fireship。”“今天的 AI 新闻但去掉 TechReview。”“过去 3 天 Reddit 的 AI 讨论要长摘要。”agent 会把问题翻译成类别、来源、时间范围、条数、摘要长短、语言这些过滤条件去查。不配 key 就能用每次最多返回 3 条想要更多条数的配置方法见仓库 README。两个项目放在这里都是 MIT 协议自己部署完整流水线github.com/frankzch/ai-news-brief装进 agent 直接查询github.com/frankzch/ai-news-skill有想加的好源也欢迎来提 issue 或 PR。](https://i-blog.csdnimg.cn/direct/08b71048eb094cbdbf68f40112866444.png)
相关推荐

新手入门避坑:网站开发需要考虑哪些方面才能不被宰

新手入门避坑:网站开发需要考虑哪些方面才能不被宰 找建站公司最怕什么?怕报价单上写着“基础版”,签完合同才发现SSL证书要加钱、服务器配置不够要升级、备案指导费另算。这种“低价引流,高价收割”的套路,坑了多少刚想搞网站的老板?我是干这行的,… · 2026/9/27 4:32:52

ob template
ob template

ob template初始化 使用Markdowm语言来撰写笔记 一级标题 item1item2 enumerateenu2 链接到笔记 链接到笔记链接笔记 快捷键: CommandP 打开命令面板快速执行命令 callout 完成笔记初始化 插入表格 ssqq11 printf链接笔记 链接到文字 链接到标题linktitl… · 2026/9/27 4:32:52

【无人机跟踪】具有有限横向加速度的UAV非线性路径跟踪制导,平面_3D 路径(直线、圆形、正弦、复合)、四种方法【含Matlab源码 15987期】

💥💥💥💥💥💥💥💥💞💞💞💞💞💞💞💞💞Matlab武动乾坤博客之家💞… · 2026/9/27 4:32:46

2026最新wordpress字不能显示?5步搞定字符编码痛点

2026最新wordpress字不能显示?5步搞定字符编码痛点 很多小白刚接触WordPress,最崩溃的瞬间不是装不上,而是页面里全是“乱码”或者某些汉字死活出不来。自己不会代码想做网站,卡在“wordpress字不能”正常显示的环节,真… · 2026/9/27 5:11:16

学工管理系统:高校学生工作数字化转型的核心引擎

✅作者简介:合肥自友科技 📌核心产品:智慧校园平台(包括教工管理、学工管理、教务管理、考务管理、后勤管理、德育管理、资产管理、公寓管理、实习管理、就业管理、离校管理、科研平台、档案管理、学生平台等26个子平台) 。公司所有人员均有多… · 2026/9/27 5:11:10

DeepSeek安装全攻略:官方客户端、API接入与本地部署详解

/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */#content_views .toc,/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */#content_views.markdown_views > p:empty:has(+ .toc),#content_views.markdown_views … · 2026/9/27 5:11:04

网站开发专家揭秘:避开性能优化坑,3步搞定透明报价

网站开发专家揭秘:避开性能优化坑,3步搞定透明报价 网站做好了没人访问,多半不是内容不行,而是底层 性能优化 没做到位。很多老板花了大几万做站,上线后加载慢如蜗牛,搜索引擎直接判死刑。 找 网站开发专家… · 2026/9/27 5:10:57

Cisco Packet Tracer 5.3 下载安装、汉化与MAC欺骗实验

/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */#content_views .toc,/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */#content_views.markdown_views > p:empty:has(+ .toc),#content_views.markdown_views … · 2026/9/27 5:10:57

高精度ADC硬件电路设计选型指南:从信号链需求到工程落地

/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */#content_views .toc,/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */#content_views.markdown_views > p:empty:has(+ .toc),#content_views.markdown_views … · 2026/9/27 5:10:57

MATLAB雷达信号脉冲压缩仿真:LFM线性调频、匹配滤波与距离分辨率实现

简介:这套Matlab仿真工具完整呈现雷达信号脉冲压缩过程,从线性调频(LFM)信号生成、目标回波仿真到匹配滤波压缩处理均有可运行代码支撑,面向电子信息工程、计算机、数学等专业学生,适用于课程设计、期末大作… · 2026/9/27 0:00:01

汕头网站建设制作厂家避坑指南:5大注意事项救急

汕头网站建设制作厂家避坑指南:5大注意事项救急 改个需求建站公司拖一周,这种憋屈事我见得太多了。 很多汕头老板找本地建站团队,签合同前看着方案挺美,一上线就变脸。 今天不聊虚的,直接拆解找 汕头网站建设制作厂家 时的5个核心 注意事项… · 2026/9/27 0:00:01

多模态虚假新闻检测实战:BERT+ResNet双塔与对比学习

简介:基于PyTorch的多模态虚假新闻检测项目完整代码包,面向自然语言处理与计算机视觉交叉方向的开发者、科研人员及毕业设计选题者,解决社交媒体中文本与图像联合识别虚假新闻的问题。系统以BERT预训练模型提取文本语义特征,以Res… · 2026/9/27 0:00:01

MATLAB雷达信号脉冲压缩仿真:LFM线性调频、匹配滤波与距离分辨率实现

简介:这套Matlab仿真工具完整呈现雷达信号脉冲压缩过程,从线性调频(LFM)信号生成、目标回波仿真到匹配滤波压缩处理均有可运行代码支撑,面向电子信息工程、计算机、数学等专业学生,适用于课程设计、期末大作… · 2026/9/27 0:00:01

汕头网站建设制作厂家避坑指南:5大注意事项救急

汕头网站建设制作厂家避坑指南:5大注意事项救急 改个需求建站公司拖一周,这种憋屈事我见得太多了。 很多汕头老板找本地建站团队,签合同前看着方案挺美,一上线就变脸。 今天不聊虚的,直接拆解找 汕头网站建设制作厂家 时的5个核心 注意事项… · 2026/9/27 0:00:01

多模态虚假新闻检测实战:BERT+ResNet双塔与对比学习

简介:基于PyTorch的多模态虚假新闻检测项目完整代码包,面向自然语言处理与计算机视觉交叉方向的开发者、科研人员及毕业设计选题者,解决社交媒体中文本与图像联合识别虚假新闻的问题。系统以BERT预训练模型提取文本语义特征,以Res… · 2026/9/27 0:00:01

了解更多?预约专属演示

我们的顾问将为您一对一讲解产品与方案

企业微信二维码